Compactação de tabela no Oracle e o conceito do HWM
Postado por Adauto Santos
Com o passar do tempo uma tabela pode passar a possuir diversos “espaços vazios”, devido a operações DML (ex: DELETE) e gerar inconsistências entre a marca d'água (HWM - High Water Marker) e a quantidade real de registros presentes na tabela e com isso deteriorar o desempenho de suas operações.
O comando
No Oracle para compactar uma tabela, basta utilizar os comandos na sequência que se segue:
alter table NOME_TABELA enable row movement;
alter table NOME_TABELA shrink space compact;
alter table NOME_TABELA shrink space;
Resumidamente, com a sequência de comandos listada acima, habilita-se a movimentação de registros dentro da tabela, a sua reorganização e o ajuste do HWM. Muitas o efeito do ajuste é imediato não se fazendo ações necessárias para o ganho de performance, mas em alguns casos pode ser necessário executar as coletas de estatísticas na sequência.
A explicação
Para entender o conceito da compactação no Oracle é necessário entender a marca d'água (HWM) e como o Oracle agrupa os datafiles em blocos.
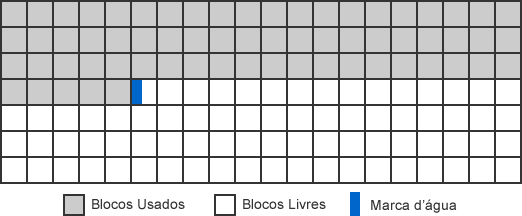
Pense em um cenário em que uma tabela é criada e em seguida tem o seu espaço ocupado em cerca de 45%. Sendo assim, a sua respectiva marca d'água irá avançar para evidenciar a utilização do espaço, como representado na figura a seguir.
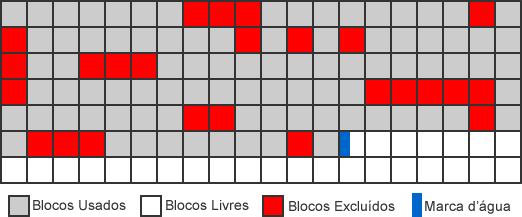
Com o passar do tempo a tabela sofre operações DML (Insert, Update e Delete) e a sua marca d'água passa a apontar para 80% de utilização, porém a tabela está fragmentada, pois cerca de 15% do espaço que deveria estar ocupado com dados está na prática vazio.
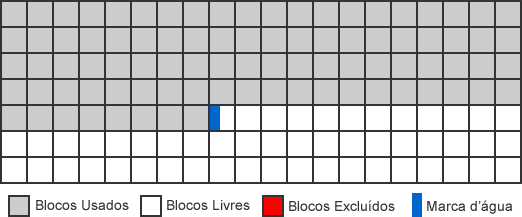
Então o processo de compactação irá fazer com que o espaço seja reorganizado de forma que a marca d'água aponte para 65% e consequemente alinhando a HWM.
Meus testes
Para comprovar o desperdício de espaço e a divergência no plano de execução ocasionada por uma marca d' água desalinhada, foi criada a tabela CLIENTE_SHRINK_20M com 20 milhões de registros com o DDL que pode ser observado a seguir.
CREATE TABLE CLIENTE_SHRINK_20M
(
   CODIGO NUMBER,
   NOME VARCHAR2(50),
   EMAIL VARCHAR2(50),
   DATA_NASCIMENTO DATE,
   UF CHAR(2),
   CODIGO_MUNICIPIO_IBGE NUMBER(10),
   NR_CPF NUMBER(11),
   REGIAO_BRASIL  CHAR(2),
   SEXO CHAR(1),
   DATA_EXCLUSAO DATE
);
Os testes foram realizados com base nas colunas REGIAO_BRASIL e UF e os registros estão dispostos da seguinte forma na tabela:
SQL> SELECT UF, REGIAO_BRASIL, COUNT(*) FROM CLIENTE_SHRINK_20M GROUP BY UF, REGIAO_BRASIL;

UF RE   COUNT(*)
-- -- ----------
RJ SD  1.428.572
SP SD  2.857.144
PR SU  5.714.284
MS CO  2.857.142
CE NE  1.428.572
MT CO  2.857.142
SC SU  2.500.000
TO NO  1.428.572
PA NO  1.428.572
RS SU  2.857.140
Utilizando o SQL do artigo Qual é mesmo o tamanho de uma tabela no Oracle? (escrito por Eduardo Legatti) constatou-se que a tabela possui pouco mais de 2GB.
TABLE_NAME                     PARTITIONED           NUM_ROWS    DATA_MB    INDX_MB     LOB_MB   TOTAL_MB
------------------------------ ------------------- ---------- ---------- ---------- ---------- ----------
CLIENTE_SHRINK_20M             NO                    19821428    2030.38          0          0    2030.38
Em seguida, executou-se a consulta abaixo, que por sua vez agrupa e conta o sexo de todos os clientes da região Sul do Brasil, obtendo um custo de 71.836 e um consistent gets de 461.079.
SQL> SELECT SEXO, COUNT(*) FROM ADAUTO.CLIENTE_SHRINK_20M WHERE REGIAO_BRASIL='SU' GROUP BY SEXO;

-----------------------------------------------------------------------------------------
| Id  | Operation          | Name               | Rows  | Bytes | Cost (%CPU)| Time     |
-----------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |                    |     2 |    10 | 71836   (3)| 00:14:23 |
|   1 |  HASH GROUP BY     |                    |     2 |    10 | 71836   (3)| 00:14:23 |
|*  2 |   TABLE ACCESS FULL| CLIENTE_SHRINK_20M |  5517K|    26M| 71332   (2)| 00:14:16 |
-----------------------------------------------------------------------------------------

Statistics
----------------------------------------------------------
          1  recursive calls
          0  db block gets
     461079  consistent gets
     258517  physical reads
...
          0  sorts (memory)
          0  sorts (disk)
          2  rows processed
Na sequência, removeu-se todos os registros da região Sul e foi executada a coleta de estatísticas da tabela, com os comandos listados a seguir.
SQL> DELETE FROM CLIENTE_SHRINK_20M WHERE UF IN ('PR','RS','SC');
11071424 rows deleted.

SQL> BEGIN DBMS_STATS.GATHER_TABLE_STATS('ADAUTO','CLIENTE_SHRINK_20M'); END;
Mesmo com a remoção de cerca 55% dos registros da tabela refazendo o SQL do teste as estatísticas foram praticamentes as mesmas, com a exceção do consistents gets que apresentou melhora (de 461.079 para 384.793). Além disso, não houve qualquer alteração no tamanho da tabela.
SQL> SELECT SEXO, COUNT(*) FROM ADAUTO.CLIENTE_SHRINK_20M WHERE REGIAO_BRASIL='SU' GROUP BY SEXO;

-----------------------------------------------------------------------------------------
| Id  | Operation          | Name               | Rows  | Bytes | Cost (%CPU)| Time     |
-----------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |                    |     2 |    10 | 71836   (3)| 00:14:23 |
|   1 |  HASH GROUP BY     |                    |     2 |    10 | 71836   (3)| 00:14:23 |
|*  2 |   TABLE ACCESS FULL| CLIENTE_SHRINK_20M |  5517K|    26M| 71332   (2)| 00:14:16 |
-----------------------------------------------------------------------------------------

Statistics
----------------------------------------------------------
          0  recursive calls
          0  db block gets
     384793  consistent gets
     256906  physical reads
...
          0  sorts (memory)
          0  sorts (disk)
          0  rows processed

TABLE_NAME                     PARTITIONED            DATA_MB    INDX_MB     LOB_MB   TOTAL_MB
------------------------------ ------------------- ---------- ---------- ---------- ----------
CLIENTE_SHRINK_20M             NO                     2030.38          0          0    2030.38
Para resolvermos essa situação serão executados os comandos que irão compactar e alinhar a marca d' água e na sequência a estatísticas serão coletadas novamente.
SQL> ALTER TABLE CLIENTE_SHRINK_20M ENABLE ROW MOVEMENT;
SQL> ALTER TABLE CLIENTE_SHRINK_20M SHRINK SPACE COMPACT;
SQL> ALTER TABLE CLIENTE_SHRINK_20M SHRINK SPACE;

SQL> BEGIN DBMS_STATS.GATHER_TABLE_STATS('ADAUTO','CLIENTE_SHRINK_20M'); END;
Para finalizar será executado novamente o comando para obter a contagem dos clientes da região Sul agrupando-os por sexo, juntamente com o comando para obter o tamanho da tabela.
SQL> SELECT SEXO, COUNT(*) FROM ADAUTO.CLIENTE_SHRINK_20M WHERE UF IN ('PR','SC','RS') GROUP BY SEXO;

-----------------------------------------------------------------------------------------
| Id  | Operation          | Name               | Rows  | Bytes | Cost (%CPU)| Time     |
-----------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |                    |     2 |    10 | 40198   (4)| 00:08:03 |
|   1 |  HASH GROUP BY     |                    |     2 |    10 | 40198   (4)| 00:08:03 |
|*  2 |   TABLE ACCESS FULL| CLIENTE_SHRINK_20M |  2099K|    10M| 40018   (4)| 00:08:01 |
-----------------------------------------------------------------------------------------

Statistics
----------------------------------------------------------
          0  recursive calls
          0  db block gets
     142864  consistent gets
     142858  physical reads
...
          0  sorts (memory)
          0  sorts (disk)
          0  rows processed

TABLE_NAME          PARTITIONED     DATA_MB    INDX_MB     LOB_MB   TOTAL_MB
------------------- ------------ ---------- ---------- ---------- ----------
CLIENTE_SHRINK_20M  NO                 1121          0          0       1121
Nota-se que a tabela foi para 1,1 GB (anteriormente estava em 2 GB - ganho de 45%) o custo foi para 40.198 (estava 71.836 - ganho de 44%) e o consistent gets foi para 142.864 (na primeira execução estava em 461.079 - ganho de 69%). Logo, pode-se concluir como uma marca d'água desalinhada pode ocasionar problemas nas consultas e no espaço de armazenamento de um Banco de Dados.
Nota 1: Para fins didáticos o exemplo foi simples, na prática o bloco também poderá estar fragmentado e a recuperação de espaço nem sempre pode ser exatamente o esperado.
Nota 2: O termo marca d'água se refere a marca deixada por uma alagamento em um casa, por exemplo, em que o último nível representa até aonde a água chegou (pelo menos foi assim que eu aprendi).
Adauto Santos
Analista de Sistemas Senior na Unimed Regional Maringá. Formado em Informática pela Universidade Estadual de Maringá. Pós-Graduado em Administração de Banco de Dados pela Metrocamp e Business Intelligence pela Unicesumar.
WebSite: http://www.adautosantos.com.br/LinkedIn: http://www.linkedin.com/in/adauto-santos-91278029
Facebook: https://www.facebook.com/adauto.santos.946